Mittelständische Unternehmen werden in ChatGPT und anderen KI-Suchsystemen eher als Quelle berücksichtigt, wenn drei Dinge zusammenkommen: Der Suchcrawler des Anbieters darf die Seite lesen (bei OpenAI ist das der OAI-SearchBot), der Text steht direkt im HTML statt erst nach JavaScript, und die Seite beantwortet konkrete Kundenfragen klar und mit Belegen. Eine Garantie, in KI-Antworten genannt zu werden, gibt es nicht, und kein Anbieter kann sie seriös versprechen. Laut einer Auswertung von Vercel (Dezember 2024) führten die großen KI-Crawler von OpenAI, Anthropic und Perplexity kein JavaScript aus; Googles Gemini nutzt dagegen die Rendering-Infrastruktur von Googlebot. Erst wenn der Text schon im ersten HTML-Abruf steht, können Fact Density und Answer-First-Struktur überhaupt zur Zitierfähigkeit beitragen.
SEO für ChatGPT beginnt damit, dass OAI-SearchBot die öffentlich erreichbare Seite abrufen kann und der ausgelieferte HTML-Inhalt konkrete Fragen klar und belegt beantwortet. GPTBot steuert dagegen die Nutzung für das Training und kann unabhängig davon behandelt werden. Eine Platzierung oder Zitation ist nicht garantiert.
- Technik: OAI-SearchBot, robots.txt, CDN und auslieferbarer HTML-Inhalt prüfen
- Inhalt: direkte Antworten, Primärquellen und nachvollziehbare Autorenschaft
- Experiment: llms.txt kann anderen Diensten helfen, ist für Google kein Rankingfaktor
Einordnung: Der GEO-Leitfaden bildet den strategischen Überblick. Dieser Beitrag behandelt einen abgegrenzten Teil davon.
- Warum GEO und Answer-First-Strukturen klassische SEO für ChatGPT erweitern
- Welche 7 Signale ChatGPT, Perplexity und GPTBot für zitierfähige Quellen bevorzugen
- Wie Sie robots.txt, GPTBot und llms.txt in 7 Schritten sauber für KI-Crawler vorbereiten
- Warum SSR, SSG und sauberes HTML für ChatGPT-SEO wichtiger sind als JavaScript-lastige Seiten
- Welche Schema.org-Entitäten Organization, Product und FAQPage die ChatGPT-Sichtbarkeit konkret stärken
- Was Google für AI Overviews und AI Mode ausdrücklich verlangt
- Welche DSGVO und § 44b UrhG-Fragen Sie bei KI-Crawling, TDM und Opt-out prüfen sollten
- Wie Sie mit Pillar-Cluster, FAQ-Blöcken und Fact Density die Chance auf KI-Zitate erhöhen
- Wie Sie in 5 Schritten prüfen, ob ChatGPT Ihr Unternehmen kennt
- Praktisches Fazit
Warum GEO und Answer-First-Strukturen klassische SEO für ChatGPT erweitern
Generative Engine Optimization (GEO) dreht die SEO-Logik um: Nicht Ranking-Position zählt, sondern ob ChatGPT, Claude oder Perplexity Ihre Inhalte als Quelle zitieren. Klassisches SEO setzt auf Keywords und Backlinks. GEO verlangt Fact Density, strukturierte Daten und thematische Autorität, weil KI-Modelle nicht nach Position bewerten, sondern nach Relevanz und Zitierfähigkeit. Das ist der entscheidende Punkt: Ihre Sichtbarkeit entsteht nicht mehr durch Platz 1 bei Google, sondern durch Präsenz in den Antworten, die KI-Assistenten generieren.
Die Entwicklung geht erkennbar in diese Richtung: Nutzer stellen Fragen zunehmend direkt an KI-Assistenten. Ein mittelständisches Beratungsunternehmen kann in diesem Kanal Kontakte verlieren, wenn ChatGPT stattdessen Wettbewerber nennt, die klare, belegte Antworten liefern (denkbares Beispiel). Sie ranken auf Position 1 bei Google? Wenn KI-Systeme Sie nicht nennen, hilft Ihnen das in diesem Kanal wenig. Die Answer Engine Optimization Strategie zeigt, wie Sie Inhalte so strukturieren, dass KI-Systeme sie als zitierfähige Quelle erkennen.
Wo liegt der echte Unterschied? Google nutzt viele Signale, darunter Links und Nutzerverhalten. KI-Systeme zitieren Quellen nach eigener Einschätzung eher, wenn Inhalte klar, faktenreich und gut strukturiert sind. Eine Seite kann auf Platz 3 bei Google stehen und in ChatGPT-Antworten trotzdem fehlen, etwa weil der Suchcrawler ausgesperrt ist, die Inhalte erst per JavaScript nachgeladen werden oder die gesuchte Aussage im Fließtext untergeht. Umgekehrt kann eine Seite mit wenigen Backlinks genannt werden, wenn sie eine Frage klar beantwortet und ihre Aussagen belegt. Wie die einzelnen Systeme gewichten, legen die Anbieter nicht offen. Für KMU heißt das konkret: Investitionen in technische Basics (strukturierte Daten, Überschriften-Hierarchie, klare Antworten) zahlen sich doppelt aus: für Google und für KI-Systeme.
Welche 7 Signale ChatGPT, Perplexity und GPTBot für zitierfähige Quellen bevorzugen
Die Sichtbarkeit in KI-Systemen wie ChatGPT oder Perplexity folgt einer anderen Logik als die klassische Google-Suche. Während Google auf Klicks optimiert, suchen LLMs (Large Language Models) nach validierbaren Fakten und einer klaren semantischen Struktur, um Sie als zitierfähige Quelle einzustufen. Die folgende Übersicht zeigt Ihnen, welche Signale für die KI-Crawler wie den GPTBot entscheidend sind, um Ihr Unternehmen als Autorität wahrzunehmen.
Mehr dazu: AI Visibility Audit: Sichtbarkeit in ChatGPT und Google.
| Signal für KI-Zitierung | Priorität für KMU | Nutzen für die Sichtbarkeit | Typischer Fehler |
|---|---|---|---|
| Answer-First Content | Hoch | Die Antwort steht im ersten Absatz und lässt sich leicht übernehmen. | Lange Einleitungen ohne Informationsgehalt („In der heutigen Zeit…“). |
| Fakten-Dichte | Sehr Hoch | Erhöht die Wahrscheinlichkeit, als verifizierte Datenquelle genutzt zu werden. | Vage Marketing-Aussagen ohne konkrete Zahlen oder Belege. |
| Schema.org Entitäten | Mittel | Maschinenlesbare Definition von Produkten, Preisen und Standorten. | Fehlende oder fehlerhafte strukturierte Daten im Quellcode. |
| SSR / SSG (Technik) | Mittel | Bots wie GPTBot können Inhalte ohne JavaScript-Ausführung sofort lesen. | Reine Client-Side-Rendering Frameworks, die Bots aussperren. |
| Crawl Access (OAI-SearchBot, GPTBot) | Kritisch | Wer den OAI-SearchBot sperrt, erscheint laut OpenAI nicht in den Suchantworten von ChatGPT. | Alle KI-User-Agents pauschal sperren, auch die Suchcrawler, aus Sorge um die eigenen Inhalte. |
| Pillar-Cluster-Struktur | Hoch | Beweist thematische Autorität durch logische Verknüpfung von Fachwissen. | Einzelne, isolierte Blogbeiträge ohne interne Themen-Hierarchie. |
| Marken-Konsistenz | Mittel | Stärkt das Vertrauen der KI in die Richtigkeit der Unternehmensdaten. | Widersprüchliche Angaben auf Website, LinkedIn und Branchenverzeichnissen. |
Sie haben nun erste Daten zur Sichtbarkeit Ihrer Inhalte. Was jetzt fehlt, ist die Gewissheit, ob KI-Systeme wie ChatGPT oder Perplexity Ihre Website tatsächlich als vertrauenswürdige Quelle zitieren können. Nutzen Sie diesen kostenlosen Selbsttest, bevor Sie technische oder redaktionelle Anpassungen vornehmen.
Wie Sie robots.txt, GPTBot und llms.txt in 7 Schritten sauber für KI-Crawler vorbereiten
Die technische Infrastruktur Ihrer Website entscheidet im Jahr darüber, ob KI-Modelle wie ChatGPT oder Claude Ihr Unternehmen als vertrauenswürdige Quelle einstufen oder schlicht ignorieren. Wenn Crawler wie der OAI-SearchBot auf veraltete Blockaden in der robots.txt stoßen, riskieren Sie den Verlust von Sichtbarkeit in der KI-gestützten Suche. Mit unserem kostenlosen AI-Readiness Check prüfen Sie in Sekunden, ob GPTBot, ClaudeBot und PerplexityBot Ihre Seite überhaupt lesen können, ein Kanal, der an Bedeutung gewinnt. Mit den folgenden sieben Schritten stellen Sie sicher, dass Ihre Daten für KI-Systeme optimal lesbar und rechtlich abgesichert sind.
- Status Quo der robots.txt prüfen. Analysieren Sie Ihre aktuelle Konfigurationsdatei im Hauptverzeichnis Ihrer Domain. Viele Unternehmen blockieren unbewusst den Zugriff für moderne Crawler, da alte Regeln noch auf veralteten SEO-Standards basieren. Ein fehlerhafter „Disallow“-Eintrag kann dazu führen, dass Ihre wichtigsten Produktvorteile in KI-Antworten fehlen.
- GPTBot gezielt steuern. OpenAI betreibt laut eigener Dokumentation drei Crawler mit getrennten Aufgaben: Der OAI-SearchBot liefert Seiten für die Suchfunktion von ChatGPT, der GPTBot sammelt Inhalte für das Training von Basismodellen, und ChatGPT-User ruft Seiten auf, wenn Nutzer das in ChatGPT anstoßen. Die Einstellungen von OAI-SearchBot und GPTBot sind unabhängig voneinander: Sie können den GPTBot sperren (kein Modelltraining) und den OAI-SearchBot erlauben (Sichtbarkeit in der ChatGPT-Suche). Änderungen an der robots.txt greifen laut OpenAI nach etwa 24 Stunden.
- CCBot und weitere KI-Crawler adressieren. Neben OpenAI betreiben auch andere Organisationen wie Common Crawl (CCBot) eigene Bots, die Webinhalte einsammeln. Prüfen Sie, ob Sie diesen Zugriff gewähren möchten. Das ist eine Abwägung zwischen Reichweite und Kontrolle über Ihre Inhalte; eine pauschale Empfehlung gibt es nicht.
- Die llms.txt Datei implementieren. Erstellen Sie eine strukturierte Textdatei namens llms.txt im Root-Verzeichnis. Das Format ist ein Vorschlag aus der Community, kein verbindlicher Standard. Google nennt Dateien dieser Art für seine KI-Funktionen ausdrücklich nicht als Voraussetzung, und für andere Anbieter ist nicht belegt, dass sie die Datei auswerten. Sehen Sie sie deshalb als günstige Ergänzung, nicht als Ersatz für gut lesbares HTML. Für eine effiziente Erstellung empfiehlt sich ein llms.txt für KMU, um technische Fehler zu vermeiden.
- Strukturierte Daten (Schema.org) validieren. Strukturierte Daten machen Angaben eindeutig. Stellen Sie sicher, dass Ihre Firmendaten, Produkte und Rezensionen über saubere JSON-LD Markups verfügen. Das hilft Suchmaschinen und anderen Systemen, Angaben richtig zuzuordnen. Für die Anzeige in Googles AI Overviews ist solches Markup nach Googles Angabe allerdings keine Voraussetzung.
- Blockaden durch Firewalls vermeiden. Prüfen Sie, ob Ihre Web Application Firewall (WAF) oder Dienste wie Cloudflare die IP-Bereiche von KI-Crawlern fälschlicherweise als Bot-Angriff werten und blockieren. Eine zu restriktive Sicherheitseinstellung führt oft dazu, dass Ihre Website für KI-Dienste „unsichtbar“ bleibt, was langfristig die Markenautorität untergräbt.
- Bot-Zugriffe regelmäßig simulieren. Nutzen Sie Tools wie den Google Search Console URL-Prüfer oder spezialisierte Crawler-Simulatoren, um zu testen, wie Ihre Seite für externe Bots erscheint. Der URL-Prüfer zeigt allerdings nur die Sicht von Googlebot; für Crawler ohne JavaScript hilft der Abruf der Seite ohne Browser, etwa per curl. Nur durch regelmäßige Tests stellen Sie sicher, dass neue Website-Updates nicht versehentlich die mühsam aufgebauten KI-Freigaben überschreiben.
Welcher Crawler wofür zuständig ist, entscheidet darüber, was eine Sperre in der robots.txt bewirkt. Die folgende Übersicht fasst die Angaben der Betreiber zusammen (Stand: Oktober 2026, Quellen am Ende des Artikels). Prüfen Sie die Dokumentation der Anbieter vor Änderungen erneut, denn Bezeichnungen und Zuständigkeiten ändern sich.
| Crawler (Betreiber) | Zweck laut Anbieter | Wirkung einer Sperre |
|---|---|---|
| OAI-SearchBot (OpenAI) | Websites in den Suchfunktionen von ChatGPT anzeigen | Gesperrte Seiten werden laut OpenAI nicht in ChatGPT-Suchantworten gezeigt. |
| GPTBot (OpenAI) | Training generativer Basismodelle | Inhalte sollen nicht für das Training genutzt werden; die Suche (OAI-SearchBot) ist davon unabhängig. |
| ChatGPT-User (OpenAI) | Seitenabrufe, die Nutzer in ChatGPT oder Custom GPTs anstoßen | robots.txt-Regeln gelten laut OpenAI hier möglicherweise nicht; für die Suche nicht maßgeblich. |
| Claude-SearchBot (Anthropic) | Qualität der Suchergebnisse für Nutzer verbessern | Laut Anthropic kann eine Sperre Sichtbarkeit und Genauigkeit in Suchergebnissen verringern. |
| ClaudeBot (Anthropic) | Webinhalte für das Training der Modelle sammeln | Künftige Inhalte werden aus den Trainingsdaten ausgeschlossen. |
| PerplexityBot (Perplexity) | Websites in den Suchergebnissen von Perplexity anzeigen und verlinken; laut Perplexity nicht für das Training von Basismodellen | Steuert, ob Perplexity die Seite für seine Suchergebnisse erfassen darf. Änderungen brauchen laut Perplexity bis zu 24 Stunden. |
| Google-Extended (Google) | robots.txt-Token: ob von Google gecrawlte Inhalte für das Training künftiger Gemini-Modelle genutzt werden dürfen | Laut Google keine Auswirkung auf die Aufnahme in die Google-Suche und kein Ranking-Signal. |
Sie haben nun die technischen Grundlagen geschaffen, damit KI-Systeme Ihre Inhalte grundsätzlich erfassen können. Doch die bloße Erreichbarkeit garantiert noch keine Priorisierung in den Antworten. Die entscheidende Frage für Sie als Unternehmer bleibt: Erkennt die KI auch die wirtschaftliche Relevanz Ihrer Angebote, oder werden Sie nur als Randnotiz geführt? Ohne eine klare strategische Einordnung Ihrer Daten bleibt das Risiko hoch, dass der Wettbewerb in den KI-Ergebnissen den Vorrang erhält.
Warum SSR, SSG und sauberes HTML für ChatGPT-SEO wichtiger sind als JavaScript-lastige Seiten
Server-seitig ausgelieferter HTML ist für Bots sofort lesbar. JavaScript-lastige SPAs dagegen verstecken ihre Inhalte hinter Rendering-Verzögerungen und kosten Sie Sichtbarkeit in KI-Suchsystemen. Die Crawler von OpenAI, Anthropic und Perplexity laden laut der Vercel-Auswertung (Dezember 2024) den HTML-Code einer Seite, führen JavaScript aber nicht aus. Lädt Ihre Seite die Inhalte erst per JavaScript nach, sehen diese Bots im ersten Abruf nur ein leeres Gerüst. Ihre Inhalte existieren dann für Besucher, fehlen aber im Material, das diese Systeme lesen. Googlebot verhält sich anders: Er rendert JavaScript. Google empfiehlt Server-Side Rendering oder Pre-Rendering trotzdem, weil es Nutzer und Crawler beschleunigt und nicht alle Bots JavaScript ausführen können.
Server-Side Rendering (SSR) und Static Site Generation (SSG) beheben das. SSR generiert auf dem Server für jeden Request vollständigen HTML-Code, mit allen Inhalten sofort dabei. Bots bekommen verwertbare Daten im ersten Response. SSG geht noch weiter: Die HTML-Seiten entstehen einmalig beim Build, werden als statische Dateien ausgeliefert. Die Ladezeiten sind sehr kurz, Rendering-Verzögerungen entfallen. Für KI-SEO bedeutet das konkret: Was im ersten HTML-Abruf fehlt, kann ein Crawler ohne JavaScript-Ausführung nicht lesen und deshalb auch nicht zitieren.
Ein typisches Szenario: Ein Beratungsunternehmen. React-SPA. Inhaltlich hochwertig. Aber die Meta-Beschreibungen, Überschriften, Fließtexte, alles wird erst nach einigen Sekunden per JavaScript nachgeladen. KI-Crawler ohne JavaScript sehen davon nichts. Nach einer Migration auf Next.js mit SSG steht derselbe Inhalt im ersten HTML. Ob sich dadurch Indexierung oder Nennungen in KI-Antworten verbessern, lässt sich nicht vorhersagen (Beispiel, kein Ergebnisversprechen). Der Unterschied ist nicht magisch, sondern technisch. Bots bekommen sofort strukturierten HTML-Code mit semantischen Tags (<article>, <section>, <h1> bis <h3>). Keine JavaScript-Warterei mehr. Sie wollen Ihre Sichtbarkeit in ChatGPT verbessern? Dann prüfen Sie zuerst: Rechtsklick → „Seitenquelltext anzeigen“. Zeigt Ihre Seite dort bereits alle Inhalte? Oder nur <div id="root"></div> mit nachgeladenem JavaScript? Wer es genauer wissen will, ruft die Seite mit curl ab: Was dort fehlt, sehen JavaScript-freie Crawler ebenfalls nicht.
Welche Schema.org-Entitäten Organization, Product und FAQPage die ChatGPT-Sichtbarkeit konkret stärken
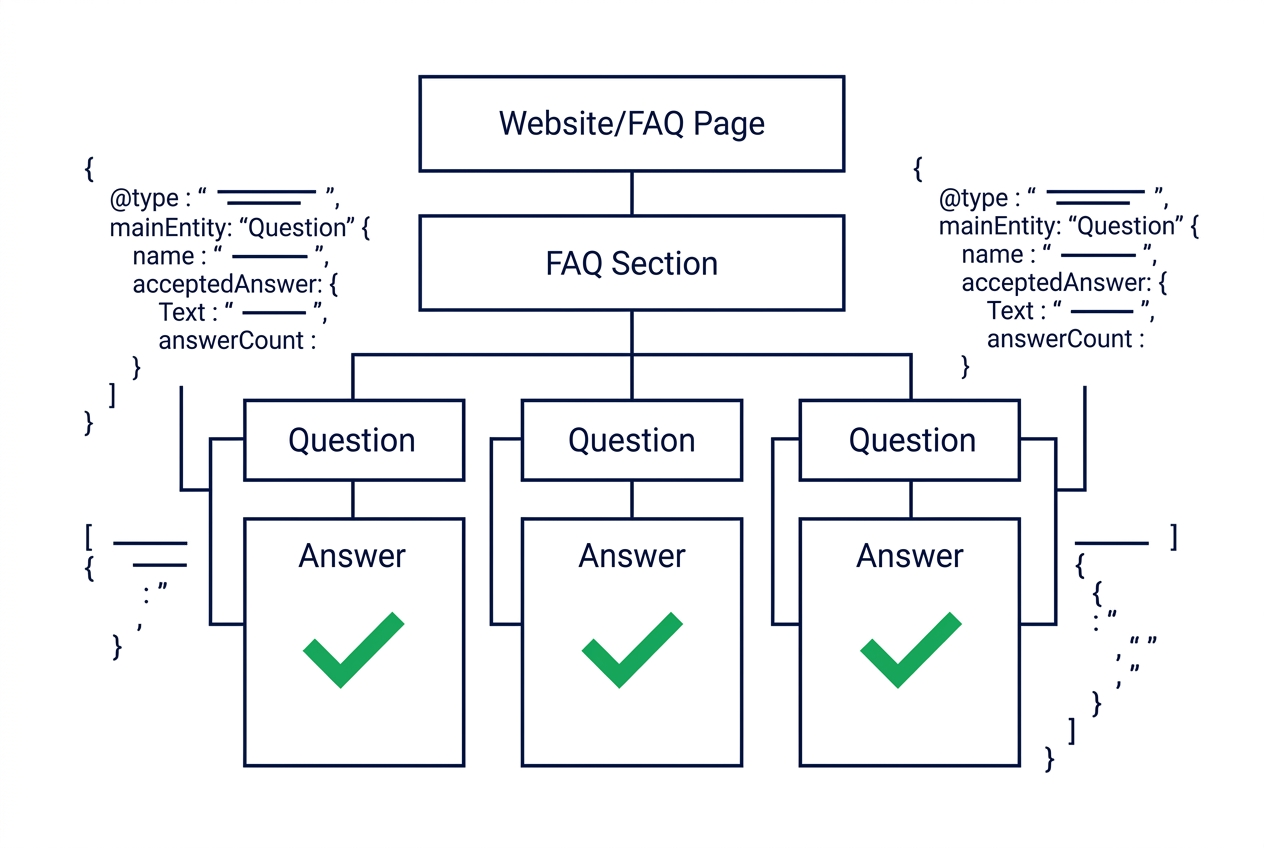
Strukturierte Daten nach Schema.org machen Angaben zu Ihrem Unternehmen maschinenlesbar und eindeutig. Ob und wie einzelne KI-Systeme dieses Markup auswerten, geben die Anbieter nicht vollständig bekannt; für Googles KI-Funktionen nennt Google es ausdrücklich nicht als Voraussetzung (siehe nächster Abschnitt). Für KMU bilden Entitäten wie „Organization“ für den Vertrauensaufbau, „Product“ für die transaktionale Relevanz und „FAQPage“ für die direkte Beantwortung von Nutzerfragen eine sinnvolle Grundlage jeder Answer Engine Optimization Strategie. Die folgende Übersicht zeigt, welche Entitäten Sie priorisieren sollten, damit Ihre Angaben eindeutig zuzuordnen sind.
| Schema-Entität | Zweck für KI-Sichtbarkeit | Typische Markup-Lücken |
|---|---|---|
| Organization | Eindeutige Zuordnung von Name, Adresse und Profilen zum Unternehmen. | Fehlende „sameAs“-Eigenschaften zu offiziellen Profilen. |
| Product / Service | Präzise Daten zu Angebot und Preis. | Mangelnde Verknüpfung zwischen Angebot und Anbieter. |
| FAQPage | Fragen und Antworten maschinenlesbar auszeichnen. | Veraltete Fragen oder fehlende semantische Relevanz. |
| Article / NewsArticle | Strukturierung von Expertenwissen und News. | Fehlende Autoren-Entitäten (Person) zur Validierung. |
| Person | Nachweis von Expertise durch reale Fachkräfte. | Keine Verlinkung zu Fachpublikationen (für KMU meist nachrangig). |
Was Google für AI Overviews und AI Mode ausdrücklich verlangt
Für die Anzeige in den AI Overviews und im AI Mode von Google gelten laut Google Search Central keine zusätzlichen Anforderungen: Die Seite muss indexiert und für ein Snippet in der Google-Suche zugelassen sein. Google schreibt außerdem, dass dafür keine speziellen Optimierungen nötig sind und Sie keine neuen maschinenlesbaren Dateien, KI-Textdateien oder Markups anlegen müssen. Das relativiert manche Empfehlung aus der GEO-Szene: Schema.org oder eine llms.txt können aus anderen Gründen sinnvoll sein, sind nach Googles Angabe aber keine Eintrittskarte für diese Funktionen. Ein Platz in den Antworten ist damit trotzdem nicht zugesichert.
- Indexierung prüfen: Ist Ihre wichtigste Seite zur Frage im Index? Der URL-Prüfer der Search Console zeigt es.
- Snippet-Steuerung kontrollieren: Mit nosnippet, data-nosnippet, max-snippet und noindex lässt sich laut Google begrenzen, was aus Ihren Seiten in der Suche, auch in den KI-Funktionen, gezeigt wird. Prüfen Sie, ob wichtige Seiten damit versehentlich eingeschränkt sind.
- Zugriffe auswerten: Zugriffe aus den KI-Funktionen von Google fließen laut Google in den Web-Bericht der Search Console ein. Eine getrennte Auswertung nur für Zitate in AI Overviews gibt es dort nicht ausdrücklich.
- Training getrennt steuern: Wer nicht möchte, dass Inhalte für Gemini-Training genutzt werden, kann Google-Extended sperren. Das betrifft laut Google weder die Aufnahme in die Suche noch das Ranking.
Welche DSGVO und § 44b UrhG-Fragen Sie bei KI-Crawling, TDM und Opt-out prüfen sollten
Text und Data Mining durch KI-Crawler regelt nicht ein Gesetz, sondern zwei, und beide greifen gleichzeitig. Das Urheberrecht (§ 44b UrhG) erlaubt Text und Data Mining an rechtmäßig zugänglichen Werken, sofern sich der Rechtsinhaber die Nutzung nicht vorbehalten hat; bei online zugänglichen Werken muss der Vorbehalt in maschinenlesbarer Form erfolgen. Datenschutzrechtlich brauchen Sie eine Rechtsgrundlage nach Art. 6 Abs. 1 DSGVO, meist das berechtigte Interesse (Art. 6 Abs. 1 lit. f). Aber Achtung: Dazu gehören Interessenabwägung, Transparenzpflichten und die Wahrung von Betroffenenrechten (Art. 12 bis 21 DSGVO), soweit Sie selbst Verantwortlicher sind. Rechtliche Prüfung im Einzelfall empfohlen.
Urheberrechtlich gilt nach dem Gesetzeswortlaut: § 44b Abs. 2 UrhG erlaubt Vervielfältigungen für Text und Data Mining, solange kein Vorbehalt nach Abs. 3 besteht. Technisch lässt sich ein Vorbehalt etwa über die robots.txt (zum Beispiel User-agent: GPTBot mit Disallow) oder den X-Robots-Tag ausdrücken. Welche Form im Einzelfall als wirksamer maschinenlesbarer Vorbehalt gilt, ist eine Rechtsfrage und sollte geprüft werden. Wegen der getrennten Crawler lässt sich ein Vorbehalt gegen Trainingszwecke setzen, ohne die Suche auszuschließen (siehe Tabelle oben). Viele Unternehmen setzen keinen Vorbehalt, weil sie in KI-gestützten Suchsystemen sichtbar bleiben wollen, und sollten die datenschutzrechtliche Seite trotzdem im Blick behalten.
Datenschutzrechtlich wird es kniffliger. Sobald ein Crawler personenbezogene Daten erfasst, Namen, E-Mail-Adressen, IP-Adressen, Nutzungsprofile, Kommentare mit Klarnamen, greift die DSGVO. Ein urheberrechtlicher Opt-out reicht nicht. Sie brauchen eine Rechtsgrundlage nach Art. 6 Abs. 1 DSGVO. In der Praxis wird meist das berechtigte Interesse (Art. 6 Abs. 1 lit. f) genannt: „Verbesserung der Suchrelevanz“ oder „KI-gestützte Antworten“. Aber dieses Interesse muss gegen die Rechte der Betroffenen abgewogen werden. Die Transparenzpflichten (Art. 13 bis 14 DSGVO) treffen den jeweils Verantwortlichen, je nach Konstellation also Crawler-Betreiber oder Website-Betreiber, und werden beim automatisierten Crawling oft nicht erfüllt. Rechtliche Prüfung im Einzelfall empfohlen. Die Betroffenenrechte (Art. 15 bis 21 DSGVO), Auskunft, Löschung, Widerspruch, müssen technisch umsetzbar sein. Fehlen diese Voraussetzungen, kann die Verarbeitung rechtswidrig sein, auch wenn kein urheberrechtlicher Opt-out vorliegt.
Ihre Checkliste: Erstens, haben Sie einen maschinenlesbaren Vorbehalt in robots.txt oder X-Robots-Tag? Zweitens, enthält Ihre Website personenbezogene Daten, die gecrawlt werden könnten? Drittens, haben Sie eine Rechtsgrundlage für die Datenverarbeitung durch Dritte dokumentiert? Viertens, erfüllen Sie die Transparenzpflichten: Datenschutzerklärung mit explizitem Hinweis auf KI-Crawling? Fünftens, können Betroffene ihre Rechte gegenüber dem Crawler-Betreiber geltend machen, und haben Sie technische Mechanismen dafür? Viele KMU-Websites erfüllen nur wenige dieser Punkte. Mögliche Folgen fehlender datenschutzrechtlicher Absicherung sind Abmahnungen, Bußgelder oder Unterlassungsklagen, nicht wegen des Crawlings selbst. Ob das im Einzelfall droht, klärt eine Rechtsberatung.
Wie Sie mit Pillar-Cluster, FAQ-Blöcken und Fact Density die Chance auf KI-Zitate erhöhen
Strukturierte, präzise und belegte Inhalte lassen sich von KI-Systemen wie ChatGPT, Claude oder Perplexity leichter als Quelle verwenden. Pillar-Cluster-Architektur, FAQ-Blöcke und hohe Fact Density unterstützen das. Klassisches SEO setzt auf Keyword-Dichte und Backlinks. Answer Engines aber fragen anders: Kann die KI Ihre Aussage als verlässliche Quelle verwenden? Ohne den Kontext zu verlieren? Die Antwort steckt in der Struktur Ihres Contents, und in der Dichte verifizierbarer Fakten pro Absatz.
Eine Answer Engine Optimization Strategie beginnt mit der Pillar-Cluster-Architektur. Sie erstellen eine zentrale Pillar-Seite (z. B. „Marketing-Automatisierung für KMU“) und verlinken thematisch fokussierte Cluster-Artikel dazu („E-Mail-Sequenzen automatisieren“, „Lead-Scoring-Modelle“, „CRM-Integration“). KI-Systeme können diese Struktur als semantisches Netzwerk erkennen und Ihre Domain als thematische Autorität bewerten. Warum? KI-Modelle suchen nach Kontext. Cluster liefern genau das.
FAQ-Blöcke sind das zweite Element. Sie liefern präzise Antworten auf konkrete Fragen, ein Format, das sich gut maschinell auswerten lässt. Entscheidend: Die Antwort muss im ersten Satz stehen, gefolgt von einer kurzen Begründung oder einem Beispiel. Vage Einleitungen wie „Es kommt darauf an“ sind tabu, KI-Systeme bevorzugen klare Aussagen mit Kontext. Ein Beispiel für das Muster (Platzhalter in eckigen Klammern): Statt „Wir bieten umfassende Beratung“ schreiben Sie „Wir beraten [Zielgruppe] in [Region] zu [Leistung]; ein Erstgespräch dauert [Dauer] und kostet [Preis, netto oder brutto].“ Solche konkreten Angaben lassen sich leichter korrekt wiedergeben als allgemeine Floskeln.
Fact Density, die Dichte verifizierbarer Fakten pro Absatz, ist der dritte Hebel. Inhalte mit vielen belegbaren Aussagen eignen sich besser als Quelle. Ein Absatz mit konkreten Zahlen, Studien oder Beispielen ist für Answer Engines wertvoller als einer mit allgemeinen Aussagen. Das heißt konkret: Jede Zahl braucht eine Quelle. Jede Behauptung ein Beispiel. Jede Empfehlung eine wirtschaftliche Begründung. Wenn Sie schreiben „Schnellere Ladezeiten verbessern die Conversion-Rate“, ergänzen Sie einen belegten Wert aus Ihren eigenen Messdaten.
Zwei weitere Formate helfen, weil sie sich ohne Umgebungstext verstehen lassen. Definitionen: Erklären Sie einen Fachbegriff in einem eigenen Absatz, in dem Begriff, Erklärung und Folge für den Leser zusammenstehen. Listen mit Begründung: Ein Eintrag wie „Titel fehlt, dadurch ist unklar, worum es auf der Seite geht“ ist verwertbarer als eine bloße Stichwortliste. Prüfen Sie jeden Absatz mit der Frage: Wäre er verständlich, wenn man ihn aus dem Artikel herauslöst?
Die Kombination dieser drei Mechaniken (Pillar-Cluster für semantische Autorität, FAQ-Blöcke für präzise Antworten, Fact Density für Zitierfähigkeit) kann Ihre Sichtbarkeit in KI-Systemen verbessern. Sie liefern nicht nur Inhalte, sondern strukturierte, verifizierbare Wissensbausteine, die KI-Modelle als verlässliche Quelle erkennen. Die praktische Frage: Welche Ihrer bestehenden Inhalte lassen sich mit minimalem Aufwand auf KI-Zitierbarkeit optimieren, und wo bringen Sie diese Maßnahmen zuerst zum Einsatz?
Wie Sie in 5 Schritten prüfen, ob ChatGPT Ihr Unternehmen kennt
Bevor Sie optimieren, messen Sie den Ist-Zustand: Stellen Sie die Fragen Ihrer Kunden selbst und halten Sie fest, was die KI-Systeme antworten. Das geht ohne Spezialwerkzeug und zeigt, ob Ihr Unternehmen genannt wird, ob die Angaben stimmen und welche fremden Quellen stattdessen auftauchen.
- Fragenliste anlegen. Sammeln Sie etwa zehn Fragen, die Kunden vor einer Anfrage stellen: nach Anbietern in Ihrer Region, nach Preisrahmen, nach Vergleichen und nach Ihrem Firmennamen. Gute Quellen sind Anfragen im Postfach, Gespräche im Vertrieb und die Suchanfragen in der Search Console.
- Fragen stellen und protokollieren. Stellen Sie jede Frage in ChatGPT, Perplexity und Google. Notieren Sie Datum, System, Fragetext und Ergebnis. Da Antworten nicht bei jeder Anfrage identisch ausfallen müssen, lohnt es sich, wichtige Fragen mehrfach zu stellen.
- Auswerten. Wird Ihr Unternehmen genannt, mit Link, und richtig beschrieben? Welche fremden Quellen (Verzeichnisse, Fachmedien, Wettbewerber) werden stattdessen genannt?
- Fehler an der Quelle beheben. Korrigieren Sie falsche oder widersprüchliche Angaben auf Ihrer Website, im Google Business Profile und in Branchenverzeichnissen. Falsche Aussagen können Sie zusätzlich über die Feedback-Funktionen der Anbieter melden.
- Regelmäßig wiederholen. Testen Sie erneut, etwa quartalsweise und nach jeder größeren Änderung an Website oder robots.txt. Werten Sie ergänzend in Ihrer Web-Analyse aus, ob Besuche mit KI-Plattformen als Verweisquelle auftauchen.
Die folgende Vorlage ist ein Muster für das Protokoll, keine Messwerte:
| Datum | System | Frage | Unternehmen genannt? | Mit Link? | Angaben korrekt? | Genannte Quellen und Notiz |
|---|---|---|---|---|---|---|
| [TT.MM.JJJJ] | [ChatGPT, Perplexity, Google] | [Kundenfrage] | [ja / nein] | [ja / nein] | [ja / teilweise / nein] | [Quellen, Auffälligkeiten] |
Praktisches Fazit
2026 ist nicht das Jahr, um SEO komplett neu zu erfinden, sondern um vier technische Stellschrauben zu drehen, damit ChatGPT, Claude und Perplexity Ihr Unternehmen zitieren können. Während viele KMU noch auf Keywords schauen, beantworten KI-Systeme Fragen bereits direkt in der Antwort, ohne dass ein Nutzer Ihre Website besucht. Wie groß dieser Anteil in Ihrer Branche ist, zeigt der Test oben. Die Frage lautet nicht mehr „Sollen wir?“, sondern „Wie schnell schließen wir die Lücke zwischen klassischem SEO und AI-Sichtbarkeit?“
Die vier Hebel sind konkret. Erstens: Crawlbarkeit für KI-Suchcrawler: robots.txt, serverseitig ausgeliefertes HTML, keine Firewall-Blockaden. Zweitens: Schema.org-Markup: FAQPage, HowTo, Product, LocalBusiness. Drittens: Antworten statt Keywords: die ersten 2 bis 3 Sätze jedes Abschnitts müssen die Frage direkt beantworten. Viertens: Messung neu denken: nicht Klicks tracken, sondern Brand Mentions in AI-Antworten, Referral Traffic aus AI-Plattformen, Validierung strukturierter Daten. Wer diese vier systematisch umsetzt, kann Brand Mentions in AI-Antworten beobachten und über die Zeit auswerten.
Das Missverständnis: ChatGPT für KMU bedeutet nicht neue Inhalte schreiben: es bedeutet, bestehende Inhalte so zu strukturieren, dass AI-Systeme sie als zitierwürdig erkennen. Stellen Sie sich einen Steuerberater vor, der seine FAQ mit Schema.org-Markup versieht. Der Aufwand: wenige Stunden. Kein neuer Text. Mögliche Folge: Nutzer kennen seinen Namen aus der AI-Antwort und fragen gezielter an.
Die Messung funktioniert anders. Sie tracken nicht Rankings. Sie tracken Citation-Häufigkeit: wie oft wird Ihre Marke in AI-Antworten genannt. Sie beobachten Referral Traffic aus AI: ChatGPT, Claude, Perplexity als separate Traffic-Quelle in Google Analytics 4. Sie messen Brand Search Volume: der Anstieg von Markensuchen nach Ihrer ersten AI-Citation. Spezialisierte Monitoring-Tools liefern erste Anhaltspunkte, aber die Interpretation bleibt Ihre Aufgabe. Ein Online-Shop, der Product-Schema und strukturierte Antworten einsetzt, kann beobachten, ob Markensuchen zunehmen und wie diese konvertieren.
Ihre nächsten vier Schritte: Erste Aufgabe: Prüfen Sie, ob robots.txt KI-Crawler blockiert (User-agent: OAI-SearchBot, GPTBot, ClaudeBot, Claude-SearchBot, PerplexityBot) und ob das Ihrer Absicht entspricht. Zweite Aufgabe: Implementieren Sie Schema.org FAQPage für Ihre wichtigsten FAQ-Seiten. Dritte Aufgabe: Strukturieren Sie Inhalte nach dem Answer-First-Prinzip, die ersten 2 bis 3 Sätze enthalten die direkte Antwort. Vierte Aufgabe: Messen Sie Brand Mentions über Google Alerts und manuelle Stichproben in ChatGPT (Vorlage im Abschnitt zum Test). Diese vier Schritte lassen sich oft ohne externe Dienstleister umsetzen, erfordern aber technisches Verständnis für strukturierte Daten und Tracking-Logik. Wo KMU scheitern: nicht bei der Umsetzung, sondern bei der Priorisierung. Welche Seiten zuerst? Welche Schema-Typen bringen messbare Citation-Effekte? Welche Antwortlogik funktioniert in Ihrer Branche? Eine professionelle Intelligente Suchoptimierung beantwortet genau diese Fragen, mit konkreten Maßnahmen und einer klaren Reihenfolge.
STEP/SEEDS® Marketing-Diagnose
Sie haben die ersten Daten und verstehen die Richtung. Was jetzt fehlt, ist die Priorisierung in Ihrem konkreten Kontext, welche Hebel zuerst, welche Investitionen sich messbar lohnen und welche Reihenfolge Geld spart. Die STEP/SEEDS® Marketing-Diagnose priorisiert Ihre Hebel für technische SEO, KI-Sichtbarkeit und Inhaltsstruktur. Sie ist in der Founder-Edition ab 199 Euro geplant, ohne Ergebnisgarantie.
Häufig gestellte Fragen
Was ist der Unterschied zwischen klassischem SEO und Generative Engine Optimization (GEO)?
Wie blockiere ich KI-Crawler wie GPTBot, ohne meine Google-Sichtbarkeit zu gefährden?
Welche Schema.org-Entitäten sind für KI-Sichtbarkeit am wichtigsten?
Ist Server-Side Rendering (SSR) oder Static Site Generation (SSG) für KI-SEO notwendig?
Wie messe ich, ob KI-Systeme meine Website tatsächlich zitieren?
Quellen (Stand: Oktober 2026)
- Google Search Central: KI-Funktionen in der Google-Suche und Ihre Website
- Google Search Central: Googles gängige Crawler (Google-Extended)
- Google Search Central: Grundlagen der JavaScript-SEO
- OpenAI: Overview of OpenAI Crawlers
- Anthropic: Web-Crawler von Anthropic und robots.txt
- Perplexity: Perplexity Crawlers
- Vercel: The rise of the AI crawler (17.12.2024)
- Gesetze im Internet: § 44b UrhG, Text und Data Mining
Hinweis: Preis- und Zeitangaben in diesem Beitrag sind eigene Einschätzungen.
Hinweis zur Erstellung: Mit KI-Unterstützung erstellt und automatisiert geprüft (Regel- und Qualitätsprüfung).
Quellen: